我这一辈子打心底觉得, 全基因组测序这档子事, 从来就没有说彻底做完, 永远都达不到那个所谓的终结的点。
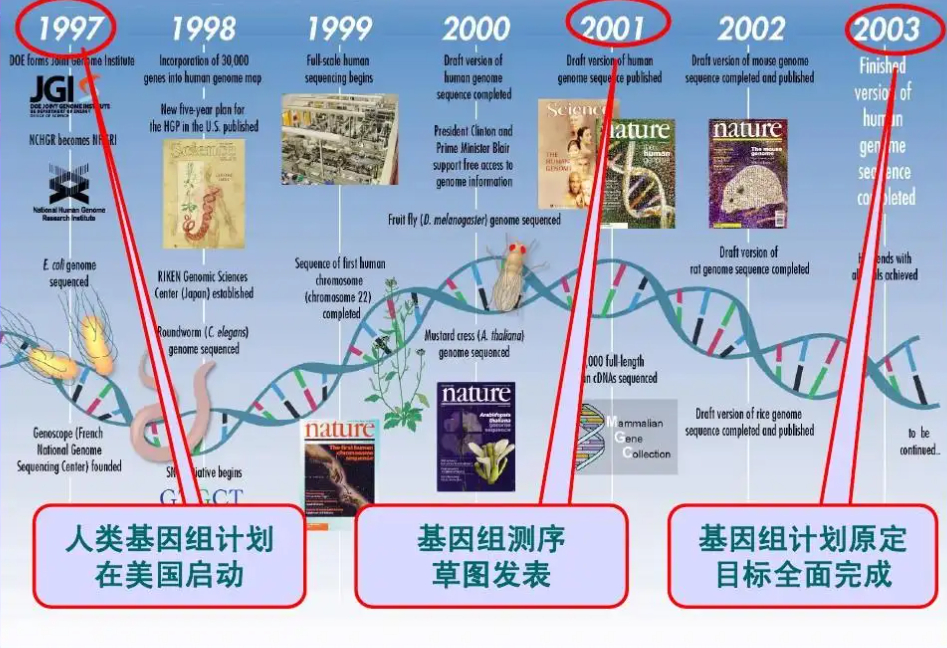
2003年这一年的事, 是人类基因组这个计划, 它花了27亿美元的钱, 还耗费了13年的时间, 仅仅只是把这30亿个碱基的初稿给读完。
把时间快进到2025年, 那些第三方的NGS平台, 已经把单人个体的下机成本压到了60美元的区间里, 测序这个东西啊, 就已经不再是什么高不可攀的大事儿, 它就变成了跟日常生活没什么两样的一种常规操作罢了。
但是, 价格低廉这一个事实, 从来就不能够被认定为是可以使用的。在基因组测序数据建库的这一系列环节之中, GC偏差、PCR重复以及脱峰效应这三次像暗墙一样的阻碍依然存在, 导致那些海量的经过机器读取下来的碱基序列数据,在质量控制的关卡面前沉默地死亡掉了。
需要给客户提供能够直接用于交付的WGS数据集, 这个数据集里边的最基本的参数要求是不能少的, 至少得包括下面这些内容吧。
平均覆盖度必须要大于或者等于30倍, 如果涉及的是肿瘤场景, 那么扩展之后的值则必须大于或者等于100倍。
Q20碱基占比 ≥ 80%

在中间的环节里面, 要插入的那一段东西, 它的长度数值在一千到五百碱基对的范围之内。
SNV检出灵敏度 ≥ 99%
结构变异断裂点置信区间 ≤ 50 bp
现在这个机器它从来都不会代替人们去做出那个什么样的正确与否的判断这个结果。测序仪它只是把那些磷酸二酯键按照一定顺序排列起来之后所产生的电信号给吐出来了而已。真正能够让这些冷冰冰的数据开口说话并且能够表达出它们想要表达的意思的东西是啥呢?
其实是后面那一些东西在起作用。比如说像dbSNP、ClinVar、gnomAD这些注释层面的东西, 还有临床知识库, 它们之间每一次那种默默发生的碰撞和互动。
所以, 等到下一次你翻开那个WGS报告的时候, 千万不要急着一眼就去看P值这个内容, 你需要先停下来问自己一个十分关键的问题, 那就是这条变异在人群频率上面是否站得住脚, 以及在功能预测方面它是不是真的处于一种沉默的状态, 答案通常就是被埋藏在那些看起来最不起眼的注释字段里面的这种地方。
其实, 我们两个, 不过也就是充当那个去给三十亿个碱基去读信的邮差角色而已。